
Méthodes créatives
Vidéo IA à partir d'une première et d'une dernière image : principe, choix des deux images et ce qui a raté dans nos tests
Ce que fait la génération vidéo par première et dernière image (images clés), quels outils la proposent, comment choisir deux images qui se raccordent, les prompts qui marchent, et le bilan de nos deux clips Veo 3.1 Fast enregistrés.
Les exemples vidéo de cet article ont été générés sur Cicadas, avec leur modèle, leurs réglages et leur date. Cicadas est rémunéré quand vous générez avec ces modèles. Notre méthode de test (en anglais)
- Période de test :
- 2026-09-08 – 2026-10-01
- Clips enregistrés avec ces modèles :
- 9
- Modèles :
- Veo 3.1 Fast
- Coût fournisseur :
- ≈8,90 $US
- Sélection :
- chaque clip conservé est listé avec ses réglages, son coût et son identifiant de requête ; les essais ratés ou écartés figurent dans le registre des tests (en anglais).
En bref : la vidéo IA par première et dernière image part d'une image d'ouverture et d'une image de fin, et génère le mouvement entre les deux. Elle donne ses meilleurs résultats quand les deux images montrent le même sujet, sous la même lumière, depuis presque le même point de vue, avec une seule différence : la caméra s'approche, la lumière change, un objet bouge. Sur Cicadas, la page première et dernière image (en anglais, comme la plupart des pages liées ici) le fait avec Veo 3.1 Fast, sans son, de 4 à 8 secondes, à partir de 100 crédits. Dans nos deux clips enregistrés, les deux extrémités ont tenu ; le chemin entre elles n'a pas toujours suivi le prompt.
Cicadas, c'est nous : la page et les clips de ce guide sont les nôtres. Les clips ont été enregistrés les 8 et 20 septembre 2026. Le 5 novembre 2026, nous les avons découpés en planches d'images, nous avons mesuré l'écart entre leurs première et dernière images et les images fournies, et nous avons lu les pages d'aide des autres outils. Les prix viennent de la tarification de la page dans notre code, lue le même jour.
Ce que fait vraiment la génération par deux images
L'image vers vidéo classique ne donne qu'une image au modèle et le laisse décider où le clip s'arrête. La méthode première et dernière image (on dit aussi image de début et de fin, ou images clés) ajoute une destination : le clip doit s'ouvrir sur l'image A et se terminer sur l'image B. Le prompt décrit le trajet.
Deux conséquences :
- Les extrémités sont des cibles, pas des copies. Le modèle redessine la scène. Dans notre clip produit, la première image obtient 0,92 et la dernière 0,86 sur une échelle de similarité de 0 à 1 (SSIM) face aux images fournies : on reconnaît clairement les deux images, sans qu'elles soient identiques.
- Le milieu est inventé. Rien dans les deux images ne dit comment passer de l'une à l'autre : le modèle choisit. Un mouvement clair et physique dans le prompt (« la caméra s'approche », « la lumière se réchauffe ») réduit ses choix.
Ce n'est pas de l'interpolation, qui ajoute des images à une vidéo existante. Ici, il n'y a pas de vidéo, seulement deux images fixes.
Où le faire
| Outil | Nom de la fonction | Remarques |
|---|---|---|
| Cicadas | Première et dernière image | Veo 3.1 Fast, 4, 6 ou 8 s, 720p ou 1080p, muet, JPG/PNG/WebP jusqu'à 8 Mo chacune, prix affiché avant |
| Google Flow | Frames : « Add start frame », « Add end frame » | L'image de fin est facultative, selon la page d'aide de Flow |
| Kling | Start and End Frames | Décrit sur la page de prise en main de Kling |
| Luma Dream Machine | Keyframes | Décrit dans le centre d'apprentissage de Luma |
Les trois outils extérieurs sont décrits d'après leurs propres pages d'aide trouvées le 5 novembre 2026 ; nous ne les avons pas utilisés pour cet article, et leurs offres changent souvent. La page Veo 3.1 de Cicadas fait tourner le même modèle en texte ou en image unique, avec le son si vous le voulez. Avec une seule image, la page image vers vidéo est plus simple.
Nos deux clips enregistrés
Les deux ont été faits sur la page première et dernière image avec Veo 3.1 Fast, 8 secondes, 16:9, 720p, sans son.
La même image au début et à la fin : un essai de boucle
Nous avons utilisé un même paysage en papier découpé comme première et dernière image, avec une caméra fixe et des nuages qui devaient « dériver doucement et revenir à leur position de départ ». Le clip s'ouvre et se ferme presque sur la même image : 0,98 entre sa première et sa dernière image. Entre les deux, l'île, la maison et la cascade ne bougent pas, mais un gros nuage passe devant l'île d'environ 2,5 à 5,5 secondes puis repart. C'est bien du mouvement, ce que nous voulions, mais en lecture répétée le clip « respire » au lieu de couler. Coût fournisseur enregistré : 0,80 $US (estimé). Ouvrir cette recette.
Pour une boucle, générez de cette façon, puis passez le clip dans l'outil gratuit mettre une vidéo en boucle, qui peut fondre la fin dans le début avant de répéter le clip, directement dans le navigateur.
Deux images différentes : un travelling avant sur un produit
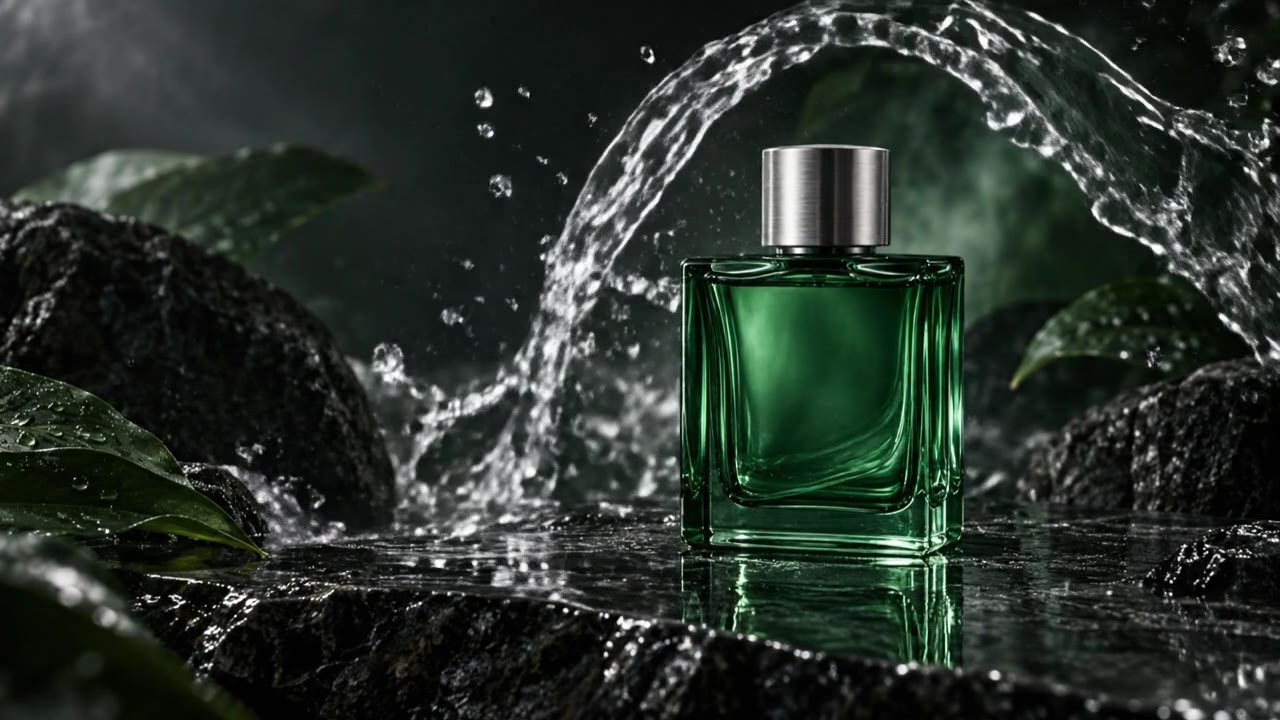
La première image était un plan large d'un flacon en verre vert sur une pierre mouillée, entouré d'un arc d'eau ; la dernière, un gros plan du même flacon. Le prompt demandait « one continuous physical camera push-in » réparti « over the full eight seconds », un flacon rigide et « no ghost images ». Ce que montre notre planche d'images :
- De 0 à 3 secondes : une vague d'eau s'abat sur le flacon, et pendant un instant on le voit à travers l'eau. C'est l'effet fantôme dont la page prévient.
- Vers 3 à 4 secondes : presque tout le travelling a lieu ici, et le flacon glisse du centre vers la droite en grossissant.
- De 4 à 8 secondes : le gros plan tient, avec des éclaboussures derrière.
Le clip commence et finit donc où nous voulions, mais il ramasse le mouvement de caméra en une seconde environ au lieu de huit. Coût fournisseur enregistré : 0,80 $US. Ouvrir cette recette. Le même flacon en image unique figure dans notre guide vidéo produit parfum.
Choisir les deux images
- Même sujet, même lumière, même objectif. Plus les deux images ont en commun, moins le modèle doit inventer.
- Une seule différence. La distance de la caméra, un changement de lumière, une porte qui s'ouvre. Deux ou trois différences à la fois, et les déformations commencent.
- Le même format que le clip. Prenez des images en 16:9 ou en 9:16 selon le clip voulu, pour que rien ne soit recadré différemment aux deux bouts.
- Tirez les deux images d'une vidéo quand c'est possible. Si vous avez déjà une vidéo et voulez un nouveau mouvement qui part et arrive sur deux de ses images, exportez-les exactement avec l'outil gratuit vidéo vers images ; notre guide pour extraire des images d'une vidéo détaille la méthode.
- Pas de texte sur les deux images. Étiquettes et lettres sont les premières à se déformer au milieu.
Deux tableaux d'une même scène fonctionnent aussi comme extrémités ; pour un seul tableau qui doit bouger sans changer, la page animer un tableau, en français, est faite pour ça.
Les prompts qui marchent
La page propose trois prompts de départ, un par type de changement. Décrivez le mouvement, puis ce qui doit rester immobile :
- Mouvement de caméra : « Move the camera slowly from the opening wide composition toward the closing close-up. Keep the same subject rigid and stable; no cuts, duplicates or morphing. »
- Changement de lumière : « Keep the camera locked while lighting changes gradually from the opening image toward the closing image. Preserve scene geometry and subject shape. »
- Essai de boucle : « For matching endpoint images, keep the landscape stable while clouds drift gently and return toward their initial positions; inspect the join before treating it as a loop. »
La page ajoute aussi sa propre phrase en anglais, qui demande d'utiliser votre première image comme ouverture et la seconde comme cible de fin, sans coupe, texte ni logo. Les prompts peuvent rester en anglais : c'est ainsi que nous les avons envoyés.
Ce qui rate, et quoi faire
| Ce que vous voyez | Cause probable | À essayer |
|---|---|---|
| Des objets se traversent ou se dédoublent | Les deux images diffèrent trop | Rapprochez-les : même angle, un seul changement |
| Le mouvement arrive d'un coup | Le modèle a choisi son propre rythme | Passez à 4 ou 6 secondes, ou réduisez l'écart entre les images |
| Quelque chose apparaît au milieu (éclaboussure, nuage) | Le modèle remplit le milieu avec ce qui va avec la scène | Nommez ce qui doit rester immobile ; retirez les éléments chargés des images |
| La fin est proche mais pas exacte | Les extrémités sont des cibles, pas des copies | Coupez les dernières images au montage si vous avez besoin d'un raccord exact |
Une génération qui échoue, ou un fichier qui ne passe pas notre contrôle, rend ses crédits ; un clip livré qui rate reste facturé, donc commencez par des clips courts et des changements modestes.
Prix, et un point à surveiller
| Durée | Crédits | Avec le pack de 1 500 crédits (15 $US) |
|---|---|---|
| 4 secondes | 100 | 1,00 $US |
| 6 secondes | 150 | 1,50 $US |
| 8 secondes | 200 | 2,00 $US |
La résolution (720p ou 1080p) ne change pas le prix sur cette page ; les packs sont sur la page tarifs. Lors de notre lecture du 15 octobre 2026, les pages de fal pour les endpoints Veo 3.1 Fast annonçaient leur arrêt le 17 novembre 2026 ; la page première et dernière image indiquera ce qui les remplace sur Cicadas.
Questions fréquentes
Qu'est-ce qu'une vidéo IA par première et dernière image ?
Vous donnez au modèle deux images fixes, une pour l'ouverture et une pour la fin, avec une phrase sur le mouvement entre les deux, et il dessine les images intermédiaires. Les deux images guident le clip sans être recopiées au pixel près : le début et la fin du résultat s'en approchent sans être identiques.
Quels générateurs vidéo IA acceptent une première et une dernière image ?
Sur Cicadas, la page première et dernière image utilise Veo 3.1 Fast. Google Flow propose une image de début et une image de fin, Kling un mode Start and End Frames, et Luma Dream Machine parle d'images clés (keyframes), d'après leurs propres pages d'aide trouvées le 5 novembre 2026. Nous n'avons testé que Cicadas.
Combien coûte une vidéo par première et dernière image sur Cicadas ?
Un clip Veo 3.1 Fast muet coûte 100 crédits pour 4 secondes, 150 pour 6 et 200 pour 8, en 720p comme en 1080p. Avec le pack de 1 500 crédits à 15 $US, un clip de 8 secondes revient à 2,00 $US. Le devis s'affiche avant la génération.
Peut-on obtenir une boucle parfaite avec la même image au début et à la fin ?
Pas de façon fiable. Avec la même image aux deux bouts, notre clip est revenu très près de son point de départ, un score de similarité de 0,98 sur 1 entre sa première et sa dernière image, mais un nuage a quand même traversé la scène au milieu et le raccord se voit si on le cherche. Fondez la fin dans le début avec l'outil gratuit de mise en boucle avant de répéter le clip.
Pourquoi ma vidéo montre-t-elle des images fantômes ?
Le plus souvent parce que les deux images sont trop différentes : autre distance, autre angle ou objets nouveaux. Le modèle doit inventer le trajet et peut fondre les images ou faire passer les objets les uns à travers les autres. Gardez le même sujet, la même lumière et le même objectif sur les deux images, et ne changez qu'une chose.
Est-ce la même chose que l'interpolation d'images ?
Non. L'interpolation ajoute des images entre celles d'une vidéo qui existe déjà, pour la rendre plus fluide ou la ralentir. La génération par première et dernière image crée un nouveau clip à partir de deux images fixes, et le modèle décide de tout ce qui se passe entre les deux.
Notre méthode
paper-loop (20 septembre 2026) et glass-transition (8 septembre 2026) sont les deux clips enregistrés sur Cicadas via fal.ai avec l'endpoint première et dernière image de Veo 3.1 Fast, chacun envoyé une seule fois, 0,80 $US chacun. Le 5 novembre 2026, nous avons exporté deux images par seconde (huit par seconde autour du travelling) et comparé les premières et dernières images aux images fournies par SSIM, en 1280 × 720. Les fonctions des outils extérieurs viennent de leurs pages d'aide trouvées le même jour. Pour un plan anime libre plutôt qu'un raccord entre deux images, voyez notre guide pour créer une vidéo anime avec l'IA, et notre façon de tester.