
Model updates
MiniMax H3 提示词指南:160 段 H3 Max 实录视频总结出的写法和模板
MiniMax H3 提示词怎么写:我们实录的 160 段 H3 Max 视频里,哪种句子顺序最稳,文生、首帧、参考图各一套可复制模板,以及模型没听的那些话。
文中视频样片均在 Cicadas 真实生成,并保留模型、参数和日期。用户用这些模型生成时 Cicadas 会获得收入。我们如何实测
- 实测时间:
- 2026-09-27 – 2026-10-30
- 这些模型的实测样片:
- 160
- 模型:
- MiniMax H3 Max
- 这些样片的供应商费用:
- ≈$46.08
- 挑选规则:
- 我们保留的样片都附参数、费用和请求编号;失败或弃用的运行也公开在实测记录中。
简单说: MiniMax H3 的提示词,最好写成一段按固定顺序的场景描述:什么样的画面、在哪里,画面里是谁,一个动作,镜头,声音,以及不要出现在画面里的东西。我们为 Cicadas 上的页面在 MiniMax H3 Max 上实录了 160 段视频,几乎每一条提示词都是这个顺序。模型在大多数视频里听了地点、人物和镜头;最不听的是声音,动作清单会被它简化,有时只是提到的东西也会被画出来。
我们做的是 Cicadas,一个通过 fal.ai 提供 MiniMax H3 Max 等模型的 AI 视频网站。这篇指南读的是我们自己的记录:2026 年 9 月 27 日到 10 月 30 日实录的 160 段 H3 Max 视频,每段按页面上展示的原样提示词只发一次,看完后写了说明。其中 55 段是文生视频,35 段用照片做首帧,70 段用一到三张照片做参考图。它们分布在 61 个页面上,其中 83 段的说明里记了和提示词不一样的地方。下面提到的每段视频都写了名字,可以去对应页面上看。
1. 站得住的顺序
两条按原样出来的提示词能说明这个结构。生日页的 birthday-candles:
A kitchen table in warm evening light, vertical. The adult from Image 1 sits in front of a small birthday cake with lit candles, smiles, takes a breath and blows the candles out, then looks up at the camera and laughs. Keep the face, hair and clothes as in the photo. The camera stays still, one continuous shot, no cuts. Sound: a soft puff of breath and quiet room tone, no music, no singing. No text, no numbers on the cake.
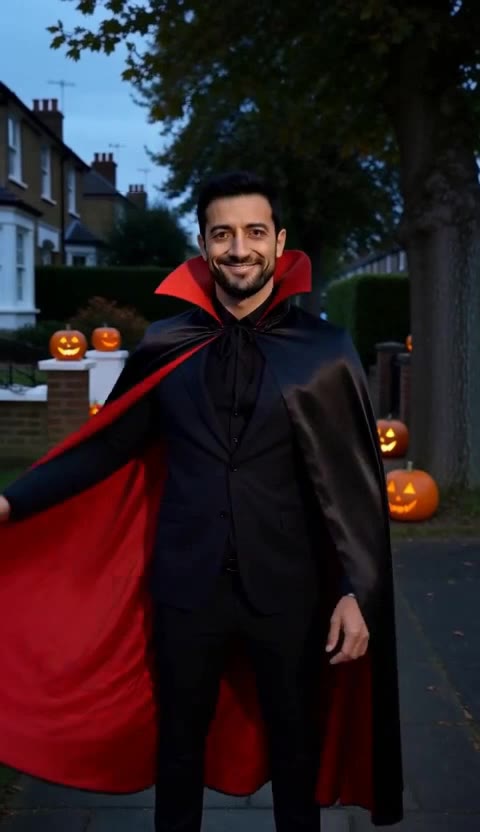
还有万圣节装扮页的 costume-walk,先写画面形式再写地点:“Vertical phone footage on a leafy suburban street at dusk on Halloween night, one continuous shot.”
各部分按顺序排列,以及各自在 160 条提示词里出现的次数:
- 画面形式和地点: “Vertical phone footage in a warm kitchen at night”。119 条提示词写了竖屏。
- 是谁: “The person from Image 1”;没有照片时直接描述主体。70 条参考图提示词都写了 “Image 1”。
- 一个动作: 一串动词,有明确的结束。
- 镜头: “The camera stays still”,或一个明确的运镜。138 条要求一镜到底。
- 声音: 一两个属于这个地方的声音。128 条有 “Sound:” 一句。
- 排除: “No text, no logos, no other people”。155 条写了不要文字。
提示词从 29 到 143 个英文词不等,中位数 79。词多不会更好,动作少才会更好。
2. 可以直接复制的模板
下面每个模板都是一段按要求出来的视频的提示词缩写版,完整提示词在那段视频的页面上。替换场景里的词,保留顺序。提示词用英文写,模型最稳。
文生视频(取自圣诞视频页的 christmas-reindeer,去掉了铃铛,原因见第 3 节):
A snowy forest clearing at blue hour with warm lights strung between two pines, vertical. A reindeer walks up to the camera, sniffs the lens and shakes the snow from its antlers. The camera stays still at its eye level, one continuous shot, no cuts. Sound: snow crunching, no music, no voices. No people, no text.
照片做首帧(取自甩发页的 bouncy-hair-tilt)。描述照片里已有东西的一个小动作,并让模型保留其余部分:
The woman in the photo makes one small, relaxed head tilt to the left and returns to center. Her hair lifts slightly and settles. Keep her face, hair and the background exactly as in the photo. Fixed camera, one continuous shot, no text.
一张照片做参考图(取自 costume-walk)。照片告诉模型是谁,句子告诉它在哪:
Vertical phone footage on a leafy street at dusk, one continuous shot. The person from Image 1 walks toward the camera, stops and grins. Keep the face, hair and build as in the photo. Sound: footsteps and a light wind, no music, no voices. No other people, no text, no logos.
两张照片(取自情侣页的 couple-beach)。在同一句里给每张照片各自的角色:
Vertical phone footage on a quiet beach at golden hour, one continuous shot. The person from Image 1 and the person from Image 2 walk along the waterline holding hands, then stop and hug. Keep both faces, hair and builds as in the photos. Natural sound only: waves and soft laughter, no music. No other people, no text.
一句台词(取自会说话的宠物页的 talking-pet-h3)。引号里只放要说的话:
The pet in the photo looks into the camera, tilts its head and says in a warm, friendly voice: "Good morning! Is it breakfast time yet?" The camera stays still, one continuous shot. No music. No text.
这段视频里嘴只在部分词上张开,所以台词要短。会说话的照片页解释了为什么引号里的“(laughs)”会被念成字。
3. 声音是它最不听的一句
83 条说明里,33 条和声音有关。反复出现三种情况。
会出声的动作,压过“不要人声”。 雨中跳舞页的 raindance-pier 要求一个人对着镜头“轻声唱”,同时写了不要人声;模型加了一段轻柔的女声。酒店大堂页的两段 hotel-lobby-duet 和 hotel-lobby-cat 都要求说唱、不要人声,结果都有一段编造词的人声。感恩节页的 thanksgiving-turkey 要火鸡咕咕叫、不要人声,出来一个尖细的声音说“Gobble, gobble!”。画面里需要嘴动,就先决定要不要这个声音,再照这个写。
没要的音乐。 拥抱页的 hug-park 写了不要音乐,却有吉他。MiniMax H3 页的 minimax-coastal-drive 根本没写声音,模型配了轻柔的钢琴。不写声音不等于安静:H3 Max 每段视频都带声音。
点名的小声音会丢。 我们有 12 条提示词提到铃铛,其中 4 段的说明写着没听到铃声:圣诞老人页的 santa-door-h3 和 santa-tree-h3、christmas-reindeer,以及精灵页的 elf-dance,试听的人听到的是嗒嗒的脚步声。写现实里最响的一两个声音就好。
4. 镜头和节奏
有 79 条提示词要求镜头不动或锁定,其中 2 段的说明写着画面还是动了:birthday-surprise 里镜头穿过门口往里推,宠物变人页的 pet-human-cat 在变化开始时画面一下拉近。另有 2 段镜头没动,是人走了过来:首帧视频 santa-name-h3 里圣诞老人一直走到镜头跟前,挡住了大半个房间;Rumpelstiltskin 页的 rumpel-hall 里他最后离镜头太近,球鞋出了画。要完整的人,就写清楚他停在哪。
节奏比文字松。变老视频页的 age-portrait 要求“在整段视频里”慢慢变老,大部分变化却挤在中间一秒左右。拥抱小时候的自己页的 younger-self-bench-hug 里,拥抱最后一秒才出现。加油站跳舞页的 gas-dance-night-solo 是 10 秒三个镜头,每个镜头约三秒,所以舞只有几步。
160 段里 142 段是 5 秒。按每 5 秒一个变化来写,并写清楚结束在哪:“by the end they look about eighty”这样的结尾,即使中间变得快,终点也是清楚的。
5. 动作清单会被简化
AI 跳舞页的 dance-studio 列了弹跳、身体波浪、交叉步、挥臂、转圈和定格;视频里只有弹跳、挥臂和一个转身,顺序也是它自己的。couple-dance 里两人都没有把头靠在对方肩上,虽然提示词要求了。排灯节页的 diwali-sparkler 要求烟花棒慢慢画圈,结果它几乎没动。一个有开头有结尾的动作,比任何清单都更接近要求。
6. 它会画出你没要的东西
写“不要文字”有用,但不保证:minimax-city-rain 里有看不清字的店招,gas-dance-dusk-trio 的油泵上有编造的字,两条提示词都写了不要文字。
提到一样东西,就可能把它画进来。万圣节视频页的 halloween-skeleton 要骷髅对镜头摘一顶“看不见的帽子”,模型画了一顶真的礼帽。爆米花火山页的 ice-volcano-drop 里一只手倒一个蓝色桶,机舱地板上又多出一个蓝色桶。肌肉页的 muscle-gym-flex 裤子上出现一个小圆徽章,提示词里没有任何一句提到它。不想在画面里看到的道具,开玩笑也别写。
7. 标签、方括号和提示词框
Cicadas 的生成框要求用一两句平实的句子写:看到什么、什么在动、光线和氛围,不用标签,不用方括号。我们实录的提示词更长,因为每条都承载一整个场景,但习惯相同:160 条里没有一条用方括号。用到的唯一标签是一句简短的 “Sound:”,也写成完整的句子;多镜头提示词用文字标出镜头(“Shot 1: ...”)。自己写提示词时,平实的描述比清单更稳:在会说话的页面上,引号里的东西都会被念出来,舞台提示也会变成台词。
8. 长度、清晰度和价格
- 5 秒: 480P 63 积分,768P 100 积分。
- 10 秒: 480P 125 积分,768P 200 积分。
- 15 秒: 480P 188 积分,768P 300 积分。
文生、首帧和参考图价格相同。63 积分按 9.90 美元 1,000 积分的首充包算约 0.62 美元。我们 160 段里 152 段用 480P,试提示词足够;提示词出了想要的效果再换 768P。生成前页面会显示报价,生成失败会退回积分。
端点细节和 fal 提供的设置,见我们的 MiniMax H3 Max 指南。要试提示词,去 MiniMax H3 页。
我们怎么测的
这 160 段是 2026 年 9 月 27 日到 10 月 30 日之间,在 Cicadas 上通过 fal.ai 实录并发布在页面上的全部 MiniMax H3 Max 视频,按网站自己的记录于 2026 年 11 月 1 日统计。每段按页面上展示的提示词只发一次;某页展示的是第二次重录时,页面上会写明。真人照片都是 AI 生成的虚构成年人示例照片。声音说明来自逐段试听,部分视频另有自动检测;两位试听者听到的不一样时,说明里会写出来。提示词各部分的出现次数,是在 160 条提示词里搜索本文引用的短语得出的。方法见我们怎么测。