
Creative workflows
怎么把自己放进 AI 视频:61 段真人照片实录告诉我们什么
把自己放进 AI 视频有两种做法:首帧和参考图。我们实录的 61 段真人照片视频里,脸保住了什么、丢了什么,什么样的照片好用,以及我们不碰的线。
文中视频样片均在 Cicadas 真实生成,并保留模型、参数和日期。用户用这些模型生成时 Cicadas 会获得收入。我们如何实测
- 实测时间:
- 2026-09-27 – 2026-10-30
- 这些模型的实测样片:
- 160
- 模型:
- MiniMax H3 Max
- 这些样片的供应商费用:
- ≈$46.08
- 挑选规则:
- 我们保留的样片都附参数、费用和请求编号;失败或弃用的运行也公开在实测记录中。
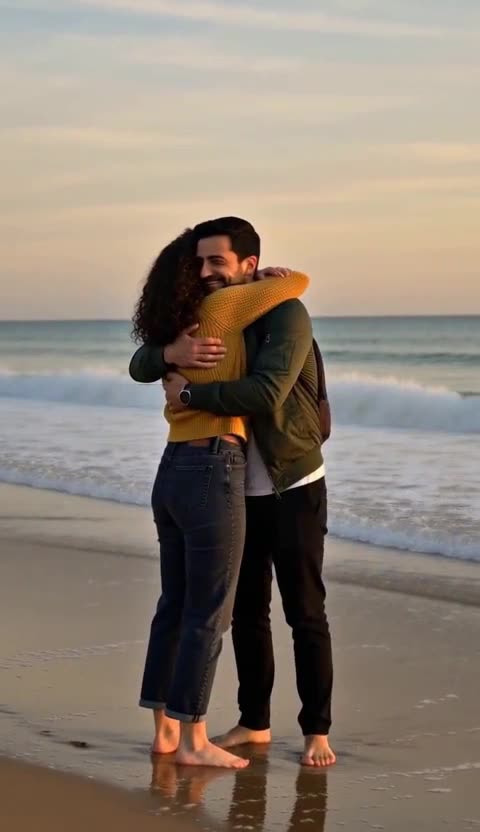
简单说: 把自己放进 AI 视频有两种做法。首帧页面上,你的照片就是开场第一帧,然后动起来,所以脸和照片一模一样,但地点也还是照片里的地点。参考图页面上,模型把你的照片当参考,把你画进新场景,所以你可以在海边跳舞、拥抱老了的自己,代价是脸会被重画一遍。我们在 Cicadas 上用真人照片实录了 61 段视频:参考图模式在大多数视频里保住了脸、发型和衣服;场景本身要改脸时就保不住;有时还会加上没人要的声音或路人。
我们做的是 Cicadas,一个通过 fal.ai 提供 MiniMax H3 Max 等模型的 AI 视频网站。下面每段视频都用 AI 生成的虚构成年人示例照片制作(两个纪念类页面用的是虚构的儿童或幼儿照片),按页面原样提示词只发一次,看完后写说明。每段都写了名字,可以去对应页面上看。
1. 两种机制,两种承诺
| | 首帧(图生视频) | 参考图(参考生视频) | |---|---|---| | 照片的作用 | 成为第一帧并动起来 | 给模型当参考,模型重新画你 | | 地点 | 照片里的背景,保留 | 页面描述的新场景 | | 你的脸 | 和照片一模一样 | 重画;通常接近,偶尔走样 | | 适合 | 给真实照片加一点变化 | 把你放到别的地方 | | 我们的真人照片视频 | 10 | 51 |
照片本身重要时,首帧页面更稳。在甩发页和哭泣滤镜页上,你上传的人像就是第一帧;走廊、光线和脸都不变,只有头发或表情在动。会说话的照片页也是这样,只是加上了说话。
大多数人说的“把我放进视频”,指的是参考图页面。站上有 39 个页面提供这种模式,从跳舞到纪念类都有(其中几页是给宠物的)。提示词把你写成 “the person from Image 1”(图 1 里的人),再描述新场景;模型画出这个场景,你在其中。
2. 保住了什么,走样了什么
51 段参考图视频里,我们看完后写的说明显示,绝大多数视频的脸、发型和衣服都跟着照片走。值得去看的几段:
- 一张照片,一个新地方。 万圣节装扮页的
costume-walk里,男人披着吸血鬼斗篷走在摆满南瓜灯的街上,胡子和深色短发和照片一致。生日页的birthday-candles里,女人吹灭三根蜡烛笑起来,卷发和毛衣都保留了。 - 两张照片,两个人。 情侣页的
couple-beach里,两人沿着海浪线走、拥抱;她的卷发和芥末黄毛衣、他的胡子和绿夹克都和照片一致。这段是本文封面。 - 一张照片,几个镜头。 加油站跳舞页的
gas-dance-night-solo里,一张照片演三个角色,同一张脸和绿夹克贯穿跳舞、自拍和下车三个镜头。用三张照片时(gas-dance-dusk-trio),每个角色保住各自照片里的脸和衣服。
像度下降有四种情况,都是场景本身决定的:
- 场景故意改脸。 丧尸特效页的
zombie-friend-hug里,丧尸是一张通用丧尸脸,切镜之前只能靠衣服认出朋友。丧尸情侣页的zombie-couple-road里,男人的脸、发型和夹克在灰皮肤下都还在,所以结果看具体哪一次。 - 年龄。 变老视频页的
age-portrait把深色卷发变灰再变白,直到她看起来八十岁左右;毛衣和姿势让视频仍然和照片对得上。 - 奇怪的身体。 人头鸽子页的
human-pigeon-bench里,头比鸽子头大得多,而且一直在笑,没有啄食。 - 道具挡脸。
costume-ghost里墨镜最后戴在她脸上,只露出一部分脸。
3. 什么样的照片好用
这里每段视频都用同几张示例照片做的,都是正脸、光线均匀、只有一个人,所以别的照片我们没有测过。下面是参考图模式需要的条件,是建议,不是实测结论:
- 正脸,整张脸都露出来。 参考图要让模型看到它要重画的五官。四分之三侧脸、头发挡眼睛,模型只能猜。
- 光线均匀。 强烈的阴影会被画成五官的一部分。
- 画面里只有你。 照片里有第二张脸会和你抢。要两个人,就用两张照片。
- 穿你想保留的衣服。 几乎每段视频都保留了衣服,所以照片也决定了你穿什么,除非场景给你换装,比如精灵页和吸血鬼页。
4. 好用的提示词怎么写
参考图页面自带场景,很多页面的场景是固定的,不能改写成别的东西。可以编辑的页面上,我们视频里效果稳定的提示词有同一个结构:
- 先写画面形式: “Vertical phone footage in a warm living room”(精灵跳舞页),或 “A locked-off full-body shot”。
- 用参考来指你: “The person from Image 1”,第二张照片再加 “the person from Image 2”。
- 一个动作: 走过来拥抱、吹蜡烛、举杯。动作列得太长,结果会走形:AI 跳舞页的
dance-studio里,他弹跳、挥臂、转身,但不是我们写的那份动作清单。 - 一镜到底, 除非页面本来就是做剪辑的。
- 声音, 写成现场的环境声。
用平实的句子。标签和括号注释可能会出现在画面或声音里。
5. 模型自己加的东西
参考图模式是整幅场景重画,空白处会用它自己的想法补上。我们视频里的例子:
- 没人要的声音。 雨中跳舞页的提示词要求不要人声,模型在
raindance-pier里加了轻柔的女声唱歌;raindance-solo里嘴型跟着的是这段生成的人声,而不是一首歌。酒店大堂页的hotel-lobby-duet里,它加了一段用编造的词说唱的人声。 - 多出来的人。 Bulin 47 页的
bulin-night里,围观的人是编出来的,而且长得很像。 - 屏幕上是你。 Babydoll 舞页的
babydoll-solo里,架子上的手机屏幕显示的是她自己的照片。 - 节奏。
younger-self-bench-hug里拥抱到最后一秒才出现;couple-dance里两人都没有像场景要求的那样把头靠在对方肩上;Heads Will Roll 页的heads-hallway里两人一起跳,但动作不同步。
这些都没有毁掉一段视频,但发出去都会显得不对。先从头到尾看一遍、听一遍。
6. 长度和价格
| 长度 | 我们的参考图视频 | 能放下什么 | |---|---|---| | 5 秒 | 35 | 一个动作:一次拥抱、一次举杯、几步路 | | 10 秒 | 14 | 两个节拍,或三个短镜头 | | 15 秒 | 2 | 三个大约 5 秒的镜头 |
5 秒是几个动作,不是一整套舞:bulin-plaza 里她只跟着节奏走了几步。MiniMax H3 Max 480P 5 秒一段 63 积分,按 9.90 美元首充包算约 0.62 美元;每个页面生成前都会显示准确报价,生成失败会退回积分。
7. 我们不碰的线
- 你自己的照片,或同意了的成年人。 每次参考图请求都带同意确认。不要上传没点头的人。
- 不用名人和公众人物。 大多数这类页面上要勾选的确认原文写着 “No celebrities, public figures or children.”
- 儿童照片只用在专门为此做的页面上。 拥抱小时候的自己收你自己小时候的照片;从小到大收你自己或你孩子小时候的照片;如果你是父母或法定监护人,生日页也收你自己孩子的照片。
younger-self-polaroid和grow-then-to-now用的是虚构的小时候照片。其他真人页面只收成年人照片。 - 不是换脸。 这里没有把你的脸放进别人视频或素材的功能,这些页面也不做换脸、换头类搜索。模型根据你自己的照片画新场景。
- 不用热门歌曲。 跳舞页生成的是原创节拍;要加音乐,用你有权使用的。
- 标明 AI。 你从没去过的地方出现了你,这就是 AI。发布时说清楚。
我们怎么测的
本文引用和统计的 61 段视频,都是 2026 年 10 月 5 日到 10 月 28 日在 Cicadas 上通过 fal.ai 生成的,全部用 MiniMax H3 Max,照片是 AI 生成的虚构成年人示例照片(sample-woman、sample-man、sample-friend),两个纪念页用的是虚构的儿童或幼儿照片(sample-child、sample-toddler)。每次请求按页面原样提示词只发一次;某段是第二次重录时,页面上会写明。数字来自截至 2026 年 10 月 28 日我们实录的视频。方法见我们怎么测。