
Creative workflows
怎么让 AI 视频看起来像实拍:手机、自拍 vlog、门铃监控和老相机质感,来自 233 段实录
我们实录的 233 段 AI 视频里,什么让画面像手机拍的、像自拍 vlog、像门铃监控或老胶片,什么会穿帮,以及一直管用的提示词结构。
文中视频样片均在 Cicadas 真实生成,并保留模型、参数和日期。用户用这些模型生成时 Cicadas 会获得收入。我们如何实测
- 实测时间:
- 2026-09-08 – 2026-10-30
- 这些模型的实测样片:
- 178
- 模型:
- MiniMax H3 Max、Veo 3.1 Fast、Grok Imagine Video 1.5、Seedance 2.0
- 这些样片的供应商费用:
- ≈$60.57
- 挑选规则:
- 我们保留的样片都附参数、费用和请求编号;失败或弃用的运行也公开在实测记录中。
简单说: 想让 AI 视频像实拍,提示词要先说是什么画面(“Vertical phone footage in a bedroom”“Handheld selfie vlog”,或者用一张门铃截图做第一帧),保持一镜到底,避开满是招牌的地方。我们在 2026 年 9 月 8 日到 10 月 28 日之间,在 Cicadas 上实录了 233 段视频,这个结构在 MiniMax H3 Max 上一直管用;会穿帮的是:没人要求的切镜头、招牌上编出来的字、多出来的小物件,以及和场景对不上的声音。
我们做的是 Cicadas,一个通过 fal.ai 提供 MiniMax H3 Max、Veo 3.1、Kling、Seedance、Grok Imagine 等模型的 AI 视频网站。下面引用的每一段视频都发布在我们的某个页面上,附有原样提示词、模型、参数,以及我们看完后写的说明。这篇指南就是从这些视频里总结的,包括出问题的那些,而不是没试过的技巧。
1. “像实拍”到底指什么
搜这个问题的人想要的通常是下面五种之一,每种都有自己的特征:
| 画面 | 真实素材的特征 | 提示词要交代的 | |---|---|---| | 手机实拍 | 竖屏、一条过、拍的人站在几步之外 | 写明 phone footage、竖屏、一镜到底、谁在拍 | | 自拍 vlog | 一臂距离取景、对着镜头说话、有环境声 | selfie vlog、一臂距离、台词放进引号 | | 固定的家用摄像头 | 广角、镜头完全不动、人朝镜头走来 | 第一帧本身就像那种摄像头拍的,加上“镜头不动” | | 老格式 | 颗粒、褪色、闪光灯、柔焦 | 只点名一种格式(拍立得、80 年代胶片、录像带),别的都不要和它打架 | | 手持特写 | 轻微晃动、取景很紧、主体占满画面 | handheld close-up、一个动作、现场的声音 |
共同点是:真实素材是由“怎么拍的”决定的,而不是“拍了什么”。所以提示词要先交代怎么拍。
2. 这篇指南的依据
| 我们在 233 条实录提示词里数到的 | 段数 | |---|---| | 开头几个词写明竖屏手机拍摄 | 26 | | 要求一镜到底(one continuous shot) | 180 | | 锁定镜头(“the camera does not move”“the framing stays fixed”) | 63 | | 要求手持晃动感 | 18 | | 要求不要文字、字母或标志 | 212 | | 仍出现编造的字母或徽标 | 5 | | 没被要求却切了镜头 | 4 |
233 段里有 157 段是 MiniMax H3 Max,所以下面大多数结论是关于这个模型的。别的模型表现不同时,我们会写明是哪一段、一共几段,通常只有一两段。请把它们当成观察,而不是排名。
3. 手机实拍:先说画面格式,再说拍谁
我们这批里最明显的规律是开头几个词。开头写明竖屏手机拍摄、接着写地点的提示词,出来的视频取景就像朋友用手机拍:全身、隔几步远、人朝镜头走或绕着镜头动,通常一条过。
- 精灵舞页面的每个场景都以 “Vertical phone footage in a warm living room” 开头,再加 “one continuous shot”。
elf-dance-jig出来是一条过的画面:人在亮着灯的圣诞树旁左右脚跳,再转一整圈、朝镜头探身,服装上没有字。 - 万圣节装扮页面的
costume-walk开在黄昏落满叶子的街道,他沿着摆满南瓜灯的人行道走,甩起斗篷、咧嘴一笑。 - Babydoll 舞页面在开着台灯的卧室里用了同样的开头,它也暴露了这种画面最大的风险,见第 7 节。
还有两个细节有用。写明谁在拍(我们的加油站场景写了 “filmed full-body by a friend”),因为这决定了距离。只给一个动作,别给一整套舞:5 秒里模型只来得及走几步。
4. 自拍 vlog:一臂距离,台词放进引号
自拍画面需要镜头在角色手能够到的地方,角色对着镜头说话。我们最清楚的两个例子在 Bigfoot 页面,都是 Veo 3.1 Fast、8 秒:
bigfoot-morning-vlog以 “Handheld selfie vlog, vertical” 开头,让大脚怪在森林里一臂距离举着镜头。它把引号里的台词一字不差说完了,底下还有脚步声和粗重的呼吸,正是这种不那么干净的声音让 vlog 显得真。bigfoot-campfire用同样的开头,在篝火边小声说了台词的第一句,第二句没说。只说半句的 vlog 会显得假,所以我们在页面上如实写了。
台词重要的话就写短(8 秒放一句话很从容),并完整听一遍。
5. 门铃和监控:让第一帧来干活
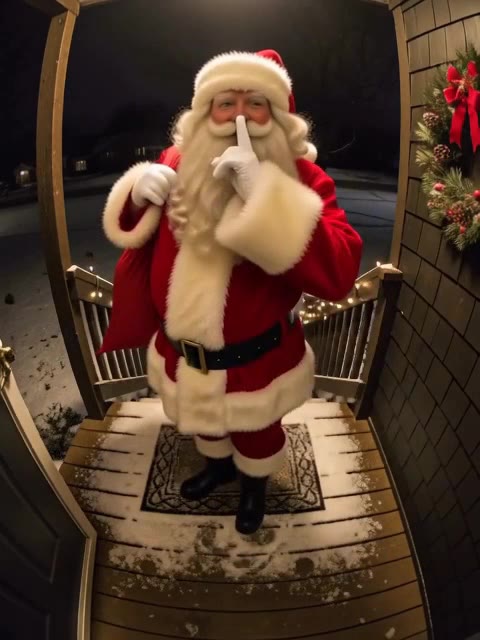
固定的家用摄像头是唯一一种“输入照片比提示词更重要”的画面。在 AI 圣诞老人页面,门铃场景的起点是一张本来就像门铃录像的截图:夜里下雪的门廊,广角、略有畸变。提示词再以 “The photo is the first frame, and the camera does not move” 开头。
结果 santa-door-h3(MiniMax H3 Max)保持了截图 3:4 的比例,门廊的灯串和花环都还在,圣诞老人在镜头跟前入画,走上门垫,转身直视镜头,竖起一根手指放在嘴边。唯一没做到的是声音:提示词要了铃铛声,片子里没有。
从 63 段固定机位视频里总结的三条:
- 在第一句就锁定镜头,不要放到最后。
- 让地点“和照片里一模一样”:同样的光、同样的东西。模型就只会加进来访的人。
- 这些都是虚构场景。这样的视频是节日娱乐,不是任何真实发生过的录像,永远不要当证据。
6. 老格式:只点名一种,然后打住
颗粒、闪光灯、褪色都很好要,也很容易过头。
- Rumpelstiltskin 页面的提示词写的是 “shot like a 1980s fantasy film with soft focus and film grain”。
rumpel-aisle里超市货架是虚的,包装五颜六色却没有一个字能看清,这反而帮了年代感。 - 后室(backrooms)页面要的是带 “slight handheld sway” 的伪纪录片画面和录像带颗粒。
qa-backrooms-h3-text的走廊都认得出,但 VHS 颗粒很弱。格式效果是重点的话,到剪辑软件里自己加,更可控。 - 拥抱小时候的自己页面的拍立得场景要的是闪光灯打亮的布帘和褪色。
younger-self-polaroid开头先停在一张静止的相纸上大约一秒,然后切到闪光灯下的画面,这一下是我们没要求的,不过和主题挺配。
7. 什么会穿帮
我们这批里大多数“一看就是生成的”瞬间,都能归到下面四类。
没人要求的切镜头。 真实手机录像是一条过。Grok Imagine 上的 grok-garage-skater,提示词结尾写了 “One continuous shot”,Grok 还是在三个机位之间切。AI 说唱页面的 Veo 3.1 Fast 视频 rap-cats-duet,中途从全景切到了近景。MiniMax H3 Max 只要提示词写了一镜到底就都遵守了,但有两段没写的 H3 视频还是切了:人头鸽子页面的 human-pigeon-street 在中途切,younger-self-polaroid(见下文)在开头一秒后切。每条提示词都写上;场景故意要切镜头时,比如加油站舞,它会切,每段大约三秒。
编出来的字。 212 条提示词要求不要文字,仍有 5 段实录视频出现编造的字母或徽标:Seedance 2.0 页面上的霓虹招牌乱码(seedance2-rain-courier)、MiniMax 雨夜街道上认不出的店招、加油机上编出来的字(gas-dance-dusk-trio)、一段 Gemini Omni 视频里的店招、肌肉视频页面里健身裤上的小圆徽标(muscle-gym-flex)。另有 3 段第一版因为同样的原因被弃用重录:雪景球底座上像刻字一样的痕迹,以及两条春节巷子门牌上编造的字。每一处都在现实中本来就有字的表面上。解决办法在选场景,而不是把“不要文字”写得更狠:选没有招牌的地方,或者让招牌小而虚。
多出来的东西。 babydoll-solo 里,人在架子上的一部手机前跳舞,手机屏幕上显示的是她自己的照片,提示词完全没要求。会显示内容的道具(手机、屏幕、镜子、海报)会引着模型往里填东西。
露馅的声音。 Seedance 2.0 的夜市特写(seedance2-night-market)里,火焰和蒸汽都很清楚,声音却是一片低沉轰鸣,不是夜市的嘈杂人声。真实素材的声音杂乱而具体。声音不对就换掉;画面再像,声音错了还是假。
8. 一直管用的提示词结构
合起来看,我们这批里像实拍的提示词都按同一个顺序写:
- 格式和画幅: “Vertical phone footage”“Handheld selfie vlog, vertical”,或 “The photo is the first frame, and the camera does not move”。
- 地点和光线: 一个房间或一条街,一个时间段。
- 谁在拍、从哪拍: “filmed full-body by a friend”“at arm's length”,固定机位就不写。
- 一个动作: 这几秒里发生什么,不是一个故事。
- “One continuous shot.”
- 声音: 那个地方的声音;有台词就放进引号。
- 文字: 要求画面里不出现文字,然后选一个容易做到的场景。
用平实的句子写。“Camera:” 这样的标签或括号里的备注,可能会出现在画面里,台词里的则可能被念出来。
9. 哪种画面用哪个模型
| 画面 | 我们用的模型 | 段数 | 看到的情况 | |---|---|---|---| | 手机实拍、家用固定机位 | MiniMax H3 Max | 手机 26、固定 63 | 写了一镜到底就守得住;有招牌的地方会冒出字 | | 带台词的自拍 vlog | Veo 3.1 Fast | 2 | 一次一字不差,一次只说了半句 | | 运动镜头、一条过 | Grok Imagine Video 1.5 | 相关 1 段 | 写了一镜到底仍切了三个机位 | | 手持特写 | Seedance 2.0 | 相关 1 段 | 画面清楚,声音太笼统 |
价格和时长在各模型页面上(MiniMax H3 Max、Veo 3.1、Grok Imagine、Seedance 2.0),每次生成前都会先显示报价。
10. 发布前检查
- 完整看一遍,找有没有没要求的切镜头。
- 在每块招牌、屏幕和衣服上暂停,看有没有编出来的字或徽标。
- 运动中数一数手和脚。
- 戴耳机听一遍,声音露馅就换掉。
- 标明是 AI。实拍感是一种风格,不是对发生过什么的陈述;用真人样貌需要本人同意。
我们怎么测的
文中引用的每段视频,都是 2026 年 9 月 8 日到 10 月 28 日之间在 Cicadas 上通过 fal.ai 生成的,按页面上展示的原样提示词只发一次,看完结果后写说明。失败和弃用的版本都留在测试记录里,某段是第二次重录时页面上会写明。本文的数字来自截至 2026 年 10 月 28 日我们实录的 233 段视频的提示词和说明;方法见我们如何测试。