
Creative workflows
用家人的照片做感恩节聚餐 AI 视频:一次实测
用两张分开的照片把两位成年人放到感恩节餐桌旁:提示词原文、5 秒成片、与提示词不一致的地方,以及我们没有测的情况。
文中视频样片均在 Cicadas 真实生成,并保留模型、参数和日期。用户用这些模型生成时 Cicadas 会获得收入。我们如何实测
- 实测时间:
- 2026-09-27 – 2026-11-12
- 这些模型的实测样片:
- 190
- 模型:
- MiniMax H3 Max
- 这些样片的供应商费用:
- ≈$56.58
- 挑选规则:
- 我们保留的样片都附参数、费用和请求编号;失败或弃用的运行也公开在实测记录中。
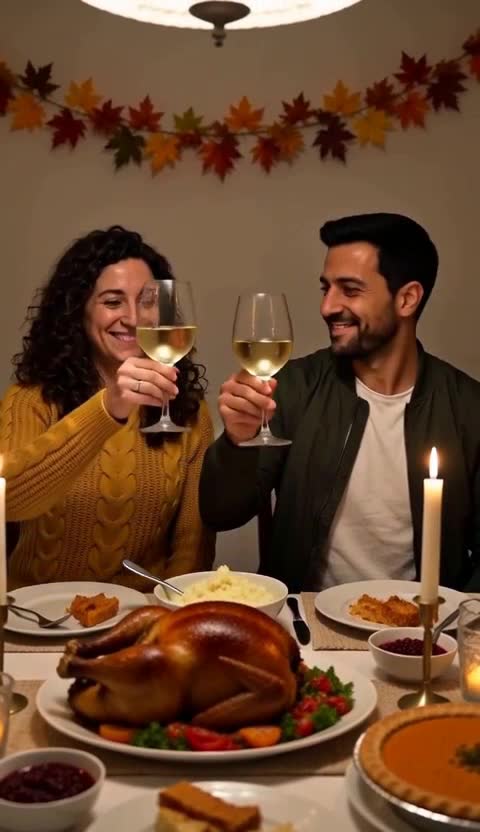
简短回答: 想把真人放到感恩节餐桌旁,要用参考图生视频页面:每位成年人一张照片,在提示词里叫「Image 1」「Image 2」。我们用两张示例照片在 MiniMax H3 Max 上跑了一次:5 秒、480P、9:16、带声音,按标价 0.25 美元。提示词、成片和不一致的地方都在下面。感恩节页面本身只用文字生成,画面里没有人。
我们做 Cicadas,所以页面链接是我们自己的。双人视频于 2026 年 11 月 12 日用站内一位女士和一位男士的示例照片生成;餐桌视频于 2026 年 10 月 13 日用文字生成。对视频内容的描述来自我们看过的帧图。新视频的声音只做了测量(平均 −28.8 dB,最大 −7.2 dB),没有逐段听,所以只引用提示词要求的声音,不描述听起来如何。
两个页面,各管一件事
我们跑的提示词原文
Image 1 是女士的照片,Image 2 是男士的照片。
One continuous shot at a Thanksgiving dinner table at home in the evening. The woman from Image 1 and the man from Image 2 sit side by side behind the table, facing the camera. On the table: a roast turkey on a platter, mashed potatoes, cranberry sauce, a pumpkin pie and two lit candles; a garland of autumn leaves hangs on the wall behind them. They raise their glasses toward the camera, clink them together, smile and laugh, and the woman passes a bowl to the man. Keep both faces and hair exactly as in the photos. Handheld family-video feel, medium shot from across the table, warm light. Sound: glasses clinking, cutlery on plates, soft laughter. No text, no logos.
出来的画面:两人并排坐在餐桌后面,桌上有烤火鸡、土豆泥、一个派、蔓越莓酱、蜡烛和酒杯,墙上挂着秋叶花环。他们举杯、碰杯、大笑。她的卷发和芥末黄毛衣、他的胡子和绿夹克都和照片一致。
与提示词不一致的地方:
- 提示词写的是女士把一只碗递给男士。视频里她的手伸向一碗土豆泥,最后碗在他手里;递的动作很短,被挡住了一部分。
- 杯子里是白葡萄酒,提示词没有写喝什么。
- 提示词要两根蜡烛,桌上不止两根。
五秒里立住了一个清楚的动作:碰杯。第二个动作被挤在最后一秒,所以一条视频只写一个动作更稳妥。
我们没有测的
一条视频只是一次测试。我们没有录过单张合照、三个人,也没有录过任何未成年人,这些都不作保证。请用已同意的成年人的照片,不要上传儿童照片。模型不会锁定身份:它是把每个人重新画出来,脸在第一秒和最后一秒之间可能有变化。
不用照片的做法
如果画面里不需要人,文字场景就够了:
更多聚餐场景(我们没有录制)
写法相同。这些我们都没有跑过,不知道出来是什么样。换掉动作那一句,其余保留。
- 切火鸡: Image 1 切火鸡,Image 2 端着盘子等。
- 传菜: Image 1 把一篮面包隔着桌子递给 Image 2。
- 祝酒: 两人站在椅子后面,向镜头举杯。
- 上派: Image 1 把南瓜派放到桌上,Image 2 鼓掌。
- 门口迎接: Image 1 打开家门,拥抱端着一盘菜的 Image 2。
在 Cicadas 上怎么做
- 每位成年人选一张清晰的正面照片,脸大而无遮挡。
- 打开 AI 参考图生视频,按你在提示词里称呼的顺序添加照片。
- 粘贴上面的提示词,改菜品或房间,保留「Keep both faces and hair exactly as in the photos」和「No text, no logos」。
- 看报价,生成,然后在开头、中间、结尾暂停,与照片对照。
- 「感恩节快乐」和名字用手机剪辑软件加;提示词要求画面里不出现文字。
费用:Cicadas 上的 MiniMax H3 Max,480P 5 秒是 63 积分,首次积分包约 0.62 美元,生成前先报价。2026 年的感恩节是 11 月 26 日,我们这次生成在供应商那边约 10 秒返回,所以来得及再试一次。其他节日页面见 AI 节日视频生成器,12 月可以看圣诞贺卡视频。用自己的照片的更多做法见怎样把自己放进 AI 视频,提示词写法见 MiniMax H3 提示词指南。
常见问题
AI 能用照片把家人放到感恩节餐桌旁吗?
部分可以。在参考图生视频页面每人上传一张照片,模型会把这些人画进一个新的聚餐场景。我们录了两位成年人、两张分开的照片;页面上限是三个人,三个人我们没有录过。
可以只传一张全家合照吗?
这个我们没有测过。我们的视频是每人一张单独的照片,在提示词里叫 Image 1 和 Image 2,能说清楚的只有这种做法。合照的效果可能不一样。
一条视频里最多能有几个人?
参考图页面接受一到三张照片,所以最多三个有名字的人。我们录的是两个人。短视频里脸越多,每张脸分到的画面越少,所以每张脸都要检查。
可以把孩子放进视频吗?
不可以。请只用已同意的成年人的照片,不要上传儿童照片。想要完全没有人的画面,感恩节页面可以用文字生成餐桌、火鸡或秋叶。
脸会和照片一模一样吗?
不保证。我们的视频里,卷发、胡子和衣服都和两张照片一致,但模型是把人重新画进新场景,细节可能改变。发出去之前,把视频暂停,和照片对照着看。
本文用到的工具
- AI 感恩节视频生成器AI 感恩节视频:烛光下的餐桌、戴清教徒帽的火鸡或漫天飞舞的秋叶,生成 5 秒带声音的竖屏视频。63 积分,不需要照片。
- AI 参考图转视频:角色一致性用自有素材制作AI 参考图转视频:角色一致性。MiniMax H3 Max 生成 5–15 秒短片,480P 最短一条 63 积分。生成前查看报价,完成后在“我的视频”中找回。
- AI Holiday Video Generator|AI 节日视频生成器AI holiday video generator 节日视频枢纽:按感恩节、黑五、圣诞、冬日飘雪或新年选择工具,也可在本页用文字生成祝福背景。支持 5、10、15 秒带声音短片。