
AI 视频提示词怎么写:Veo 3.1、可灵 3.0、Seedance 2.5 通用公式,附 12 条可直接粘贴的示例
一套所有主流视频模型都能读懂的六段式镜头公式,Veo、可灵、Seedance 各自的写法要点,12 条拿来就能用的提示词,以及五种最常见失败的修法。
视频模型不是聊天机器人。它不想要情绪板,它想要分镜单。下面的公式就是我们各个页面提示词模板在用的写法,在 Veo 3.1、可灵 3.0、Seedance 2.5、万相 3.0 以及其他模型上都能出可用的第一版。
六段式镜头公式
一个镜头写一句话,按这个顺序:
- 主体:画面里是谁或什么,带两三个视觉细节(「穿亚麻围裙的咖啡师」)。
- 动作:一个明确的动词加方向(「拉花,蒸汽升起」)。
- 镜头:景别和运动(「手持特写,缓慢推近」)。
- 光线与场景:时间和光质(「阳光咖啡馆,温暖的窗光」)。
- 声音:环境音、音效,以及用引号括起来的台词(「轻声交谈;她说『给你』」)。
- 切镜:只有需要第二个镜头时才写,另起一句并换一个镜头。
六段齐全的提示词很少被误读;缺动词或缺镜头的提示词,是「画面不动」「很平」这类结果的主要来源。
时长、画幅与音频
- 先用模型允许的最短时长打草稿(多数模型是 4 或 5 秒,LTX-2.5 Fast 是 6 秒),定稿再拉长。积分按秒计,草稿很便宜。
- 抖音、Reels、Shorts 用 9:16;YouTube 和网页用 16:9;信息流广告用 1:1。按画幅描述构图:竖屏要把主体放中间、拉近。
- 只在镜头需要时才开音频。可灵 3.0 Pro、Veo 3.1 Fast、Seedance 2.5、Seedance 2.0、万相 3.0 Prime 和 LTX-2.5 Fast 都可以关闭音频、出静音草稿;Gemini Omni Flash 1.1、Grok Imagine Video 1.5 和 MiniMax H3 Max 总是自带配乐;万相 2.7 则总会返回原生音轨,没有开关。
实测样片给音频提示词的启发
2026 年 9 月 27 日,我们为每个模型各生成了一条样片,并用自动化流程检查了每条样片的音轨——由 google/gemini-3.5-flash-lite 描述它听到的内容,而不是人工听审。一个模型一条样片算不上基准测试,但这个规律值得记一笔:总是自带声音的模型,有时会加一段配乐,而不是你描述的那种环境音,也不会保持安静或逐字匹配。
两个例子把这个差距体现得很清楚。一条 Grok Imagine Video 1.5 的提示词要求宇航员穿过火星红色沙丘时有风声和脚步声,实际返回的音频却是一段平静的背景音乐。
一条 Gemini Omni Flash 1.1 的提示词写的是雨中书店里的猫,要求雨声和雷声,返回的同样是柔和的背景音乐。
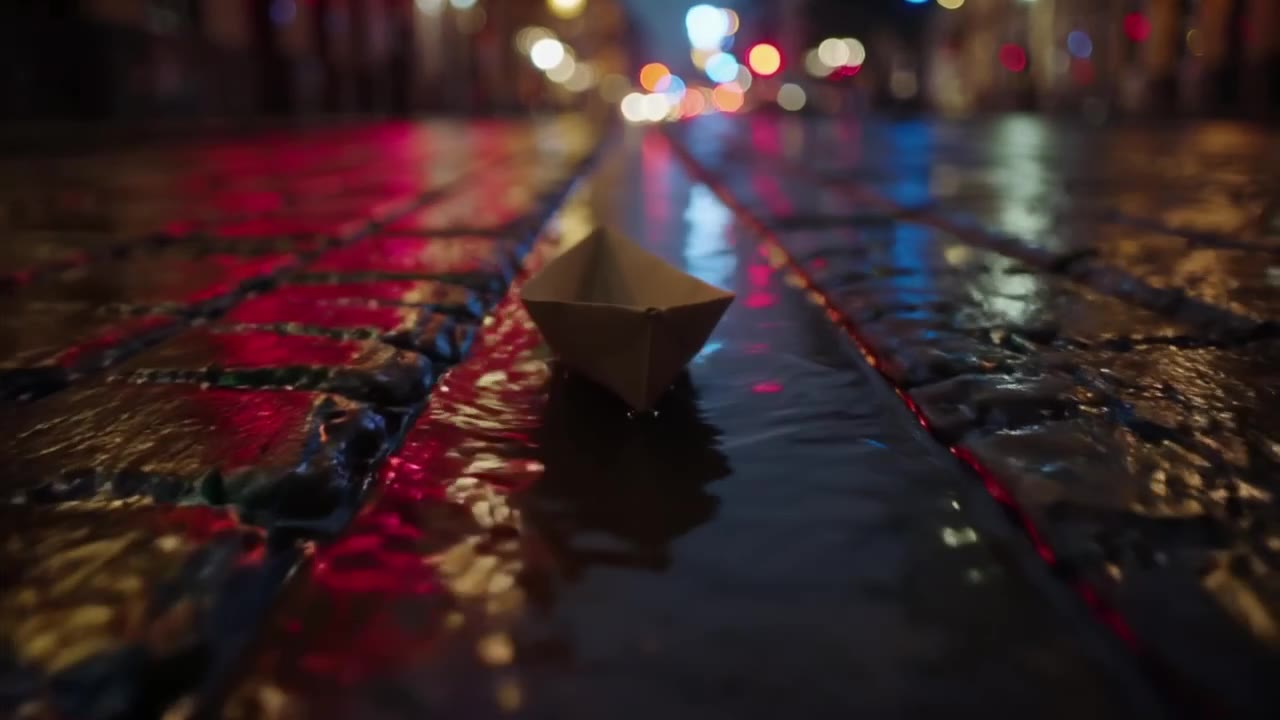
相比之下,这批样片里主动开启音频的可选音频模型更接近字面描述。LTX-2.5 Fast 上,纸船漂过潮湿街沟的镜头返回了类似风声的沙沙声:
给提示词里声音这一句两个实用建议:
- 在总是自带声音的模型上——Gemini Omni Flash、Grok Imagine Video 1.5,或 MiniMax H3 Max——把声音写得和画面一样具体(「风声呼啸,靴子踩在沙地上」,而不是只写「有风」),生成后先回放,再决定是否采用;它仍然可能换成配乐。
- 如果镜头依赖某种特定声音,先用支持静音的模型起步——可灵 3.0 Pro、Veo 3.1 Fast、Seedance 2.5、Seedance 2.0、万相 3.0 Prime 或 LTX-2.5 Fast——先出静音草稿,定稿再开音频。
一个模型一条实测样片只是方向性参考,不能保证你下一条提示词的结果。查看完整模型对比,了解全部十款模型的时长、分辨率和积分价格。
各模型要点
Veo 3.1 对长提示词遵循度高,语音表现好。台词放在引号里,8 秒片段控制在十来个词以内,需要时注明口音或语气。镜头首尾固定时用首尾帧模式。
可灵 3.0 是动作专家。用具体的物理动词(冲刺、甩、溅),注明速度(慢动作、实时),再加一个运镜;「贴地低机位跟拍」比形容词管用得多。Pro 档支持多镜头提示词:一句一镜。
Seedance 2.5 会在镜头或场景变化的句子之间切镜,单镜头可以拉到 30 秒。想要一镜到底,就保持一个镜头,描述动作如何随时间演变(「她从门口走到窗前,光线从蓝色转为金色」)。
任何模型的图生视频:图片决定主体、构图和色彩,提示词只描述运动和镜头,不要重复画面里已有的东西。
12 条拿来就能用的提示词
- 商品,9:16,6 秒,Veo 3.1 Fast:哑光黑色水壶放在白色桌面上的干净影棚镜头,缓慢的 180 度转盘旋转,柔和的轮廓光扫过标签,画面无文字。
- UGC 广告,9:16,8 秒,Veo 3.1:明亮厨房里的手机自拍视角,一位三十多岁的女性把咖啡豆袋举向镜头,说「用了三周,回不去了」,自然晨光,随意的语气。
- 动漫,16:9,5 秒,可灵 3.0:赛璐璐动漫风,女高中生在日落的桥上奔跑,头发和裙摆随风飘动,樱花花瓣飘落,镜头在她身侧跟拍,轻快钢琴。
- 自然,16:9,8 秒,Veo 3.1:无人机在黎明的雾气松林上方升起,金色光线穿透树冠,缓慢向前漂移,风声与远处鸟鸣。
- 美食,1:1,5 秒,Seedance 2.5:蜂蜜浇在乡村木桌上一叠松饼上的微距镜头,晨光从窗户洒入,缓慢下摇,画外轻微的煎锅声。
- 动作,16:9,10 秒,可灵 3.0:两名武者在霓虹招牌下雨水浸透的小巷对练,慢动作出击后切回实时反击,水花四溅,鼓点与击打同步,低机位跟拍。
- 音乐视频,9:16,15 秒,Seedance 2.5:空仓库里单束聚光灯下的歌手,烟雾飘动,镜头缓慢环绕。副歌时切到特写,镜头眩光,呼出的白气可见。
- 对白,16:9,8 秒,Veo 3.1:两位朋友深夜坐在天台,身后是城市灯火,中景双人镜头;一人说「我们早该这么做了」,另一人笑了,远处车流声。
- 无人出镜 B-roll,9:16,10 秒,Seedance 2.5:日出时的极简书桌,咖啡热气缭绕,合上的笔记本电脑,缓慢横摇整个房间,没有人,平静高效的氛围,无文字。
- 照片动画,9:16,5 秒,LTX-2.5 Fast(图生视频):她眨眼、轻轻微笑,微风吹动发丝,镜头非常缓慢地推近。构图和色彩与照片完全一致。
- 房产,16:9,10 秒,万相 3.0:稳定器从入口平滑走进明亮的客厅,午后阳光穿过高窗,轻微的房间底噪,没有人。
- 奇幻,16:9,8 秒,Gemini Omni Flash:黄昏时一条巨龙盘绕在山间寺院上,僧人敲响大钟,云层散开,大远景缓缓上升,低沉的管弦乐渐强。
把任意一条粘贴到对应模型页的生成器里,先换名词;镜头和光线的词保留,它们承载了大部分风格。
五种常见失败与修法
- **画面不动。**给主体加动词,再加一个运镜。「沙发上的猫」改成「猫伸了个懒腰跳下沙发,镜头下摇跟随」。
- **人脸在帧之间变了。**要求少一点:轻微动作、一个运镜、不要大幅转头。图生视频时完全不要描述脸。
- **文字是乱码。**模型拼不准字。写上「画面无文字」,标题在剪辑软件里加;商品标签要清晰,就用包装图做图生视频。
- **第二个镜头被忽略。**每个镜头要有自己的句子和镜头指令,并且时长要够(Seedance 和可灵上两个镜头需要 10 秒以上)。
- **台词含糊或太长。**缩短台词,放进引号,并在同一句里给角色一个说这句话的理由。