
Bulin 47 AI 视频生成器
用 1 到 2 张照片生成 Bulin 47 AI 同款视频:街头即兴、音箱和围观的人,5 到 15 秒。10 秒 125 积分。不做换脸。
- 每条 63 积分起
- 用你的照片生成
- 5s / 10s / 15s
- 480P
- 可带音频
样片效果
10s · MP4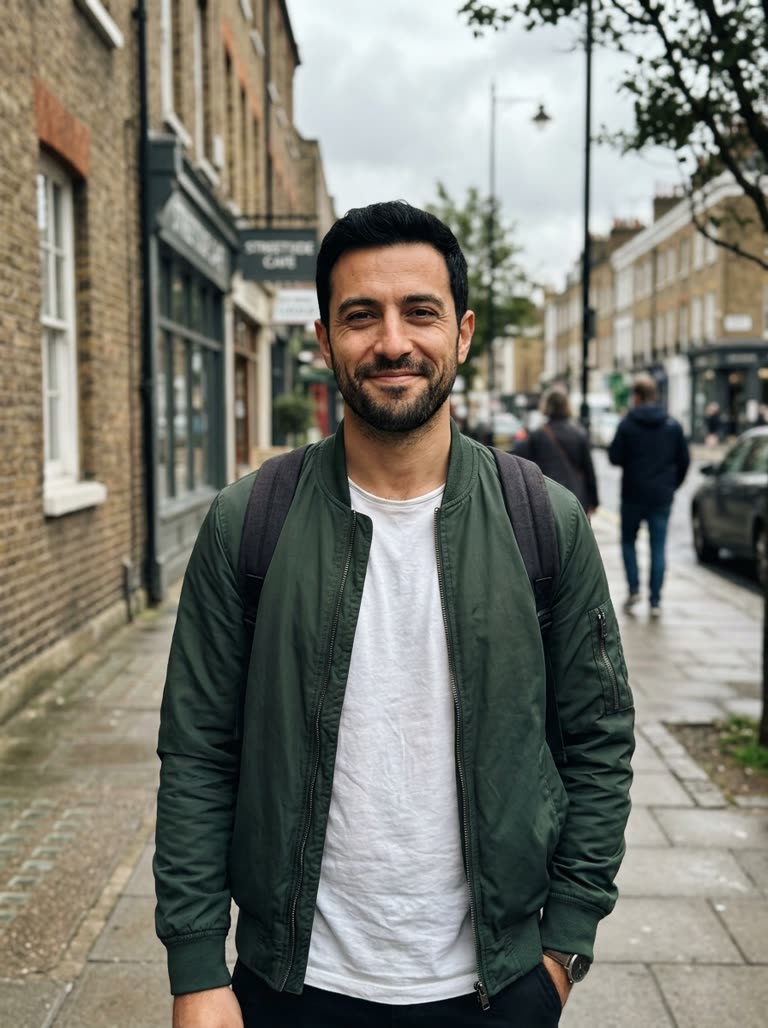 即兴的人
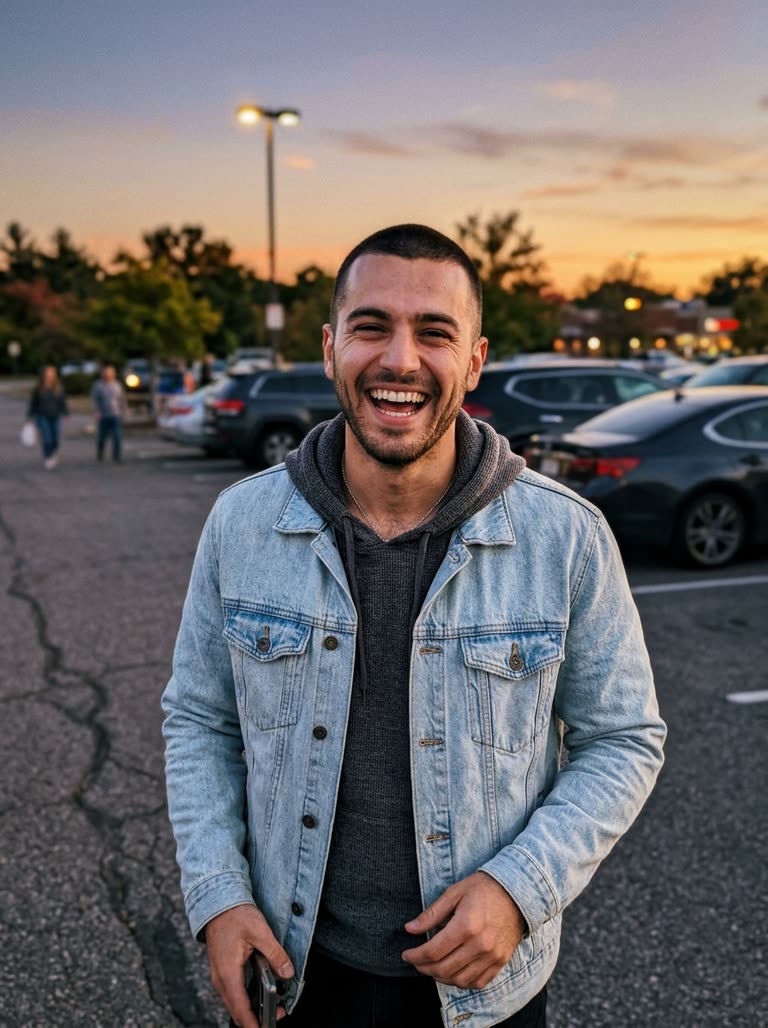 举音箱的人
关于 Bulin 47 AI 视频
Bulin 47 AI 把一到两张照片变成一段竖屏街头即兴视频,风格贴近 Bulin 47 这个热门玩法:一个人在人行道上即兴,朋友举着音箱,旁边有人围观。Cicadas 用 MiniMax H3 Max 生成一段 5、10 或 15 秒的新视频。它不会把你的脸换到原视频上,也不使用原视频的声音。10 秒 125 积分。
Bulin 47 AI 视频真实样片
街头即兴,朋友举着音箱。
MiniMax H3 Max,10 秒,带声音,竖屏,用两张照片生成。他在夜晚的街头即兴,一只手拍着胸口,穿牛仔夹克的朋友在旁边举着小音箱;两人的脸和穿着都保留。围观的人是模型编出来的,长得很像。声音是快节奏的电子节拍,带一段重复的喊唱,尽管提示词要求不要人声。
- 即兴的人
- 举音箱的人
一张照片,白天的广场。
MiniMax H3 Max,5 秒,带声音,竖屏,用一张照片生成。她在城市广场上随节拍律动,地上放着一个小音箱,身后有路人。5 秒只有几个动作,不是一段完整的即兴。声音是轻快的电子节拍。
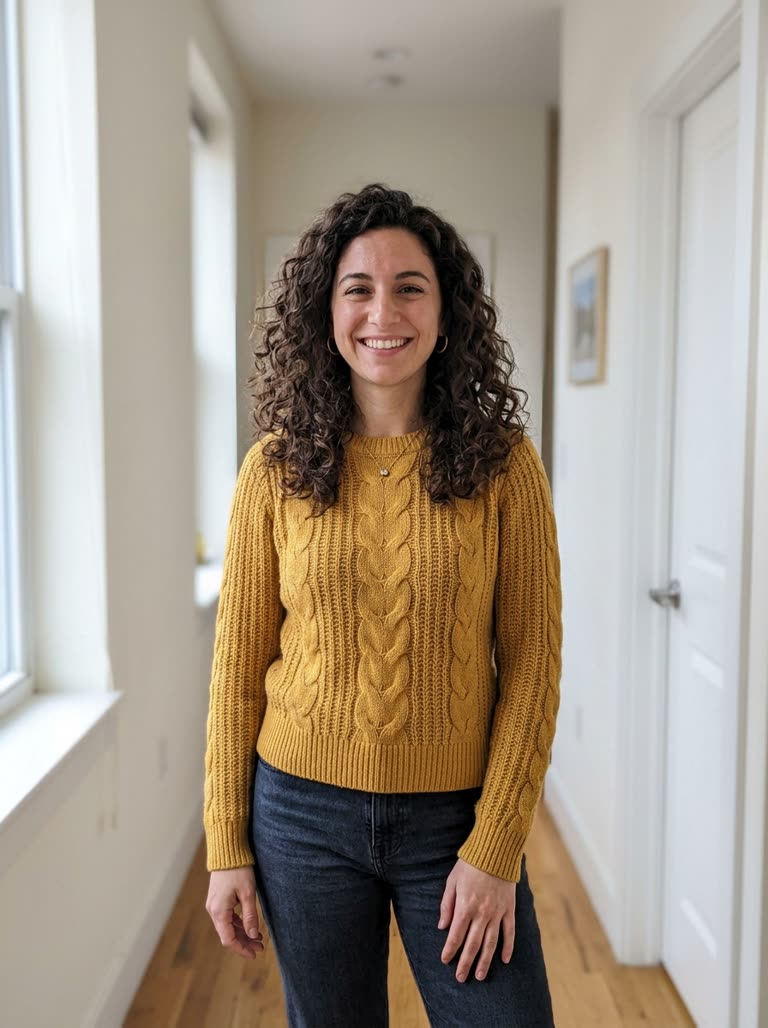 即兴的人
为什么在 Cicadas 做 Bulin 47 AI 视频
用你自己的照片生成 Bulin 47 AI 视频
第一张照片是即兴的人,第二张是举音箱的朋友。第二个位置留空时会再用一次第一张照片。
是新视频,不是换脸
这个玩法的多数版本是替换原视频里的人脸。本页是根据文字描述画出一个新场景,所以街道、人群和动作每次都是新的,不会把任何人剪进别人的视频。
生成的节拍,不是原声
MiniMax H3 Max 会和画面一起生成声音:我们的测试里是快节奏的电子节拍,有一次带喊唱。不包含原来的即兴和节拍。480P 下 5 秒 63 积分,10 秒 125 积分,15 秒 188 积分;768P 分别是 100、200、300 积分。
Bulin 47 AI 视频使用步骤
- 01
登录后为每个人放一张清晰的正面照片:即兴的人,以及举音箱的朋友。
- 02
选择场景(夜晚街头、白天广场或面对面),选 5、10 或 15 秒,核对报价。
- 03
勾选照片确认后生成,在“我的视频”下载 MP4,发布时再加上你的声音。
Bulin 47 AI 视频提示词示例
复制后粘贴到上方的提示词框,再按你的画面修改。 或者用提示词生成器按镜头写一条。
“Vertical phone footage on a city street at night outside a restaurant, one continuous shot. A loose ring of onlookers stands on the pavement around the person from Image 1, who freestyles to the beat: a glance to the side, a side-to-side groove with loose shoulders, a tap on the chest, a point at the crowd, then a freeze with a smirk. Beside them the person from Image 2 holds a small portable speaker at chest height and nods along. Keep each face, hair and outfit as in its photo. Warm streetlight, handheld camera with a gentle wobble. Sound: a hard, fast dembow-style beat, no vocals. No text, no logos, no shop signs.”
“Vertical phone footage in a sunny city plaza, one continuous shot. A few passers-by stop to watch the person from Image 1, who freestyles to a beat from a small speaker on the ground: a side-to-side groove, quick hand gestures toward the camera, a tap on the chest, then a freeze with a grin. Keep the face, hair and outfit as in the photo. Bright daylight, handheld camera. Sound: a hard, fast dembow-style beat, no vocals. No text, no logos, no shop signs.”
“Vertical phone footage on a city street at night, one continuous shot. The people from Image 1 and Image 2 stand face to face and take turns freestyling with big hand gestures, each nodding while the other goes, a small speaker on a ledge between them and a few onlookers behind. Keep each face, hair and outfit as in its photo. Warm streetlight, handheld camera. Sound: a hard, fast dembow-style beat, no vocals. No text, no logos, no shop signs.”
Bulin 47 AI 视频常见问题
在 Cicadas 的实测记录 · 审核于 2026-10-11
2026-10-11 通过 fal.ai 的 MiniMax H3 Max 参考图生视频实测,请求体由本站的输入映射生成:一条 10 秒、两张照片的夜晚街头视频(本站 125 积分,28 秒返回),一条 5 秒、一张照片的广场视频(63 积分,25 秒返回),均为 9:16、480P、带声音。即兴的人和举音箱的朋友都保留了脸和穿着;模型编出来的围观者长得很像。声音是快节奏的电子节拍,较长的那条带有一段喊唱,尽管提示词要求不要人声(两个自动听辨模型)。面对面场景、768P、15 秒,以及从本页完整走一遍生成,都没有实测。
更新于 2026年10月11日 · 我们怎么测试
相关工具
 MiniMax H3 Max · 本站实测样片
Raindance AI 视频生成器
用 1 到 2 张照片生成 Raindance AI 视频:黄昏海边的码头、沙滩和日落,5 到 15 秒。15 秒 188 积分。不含原曲。
MiniMax H3 Max · 63 积分起
实测记录 2026-10-11
 MiniMax H3 Max · 本站实测样片
Hotel Lobby AI 视频生成器
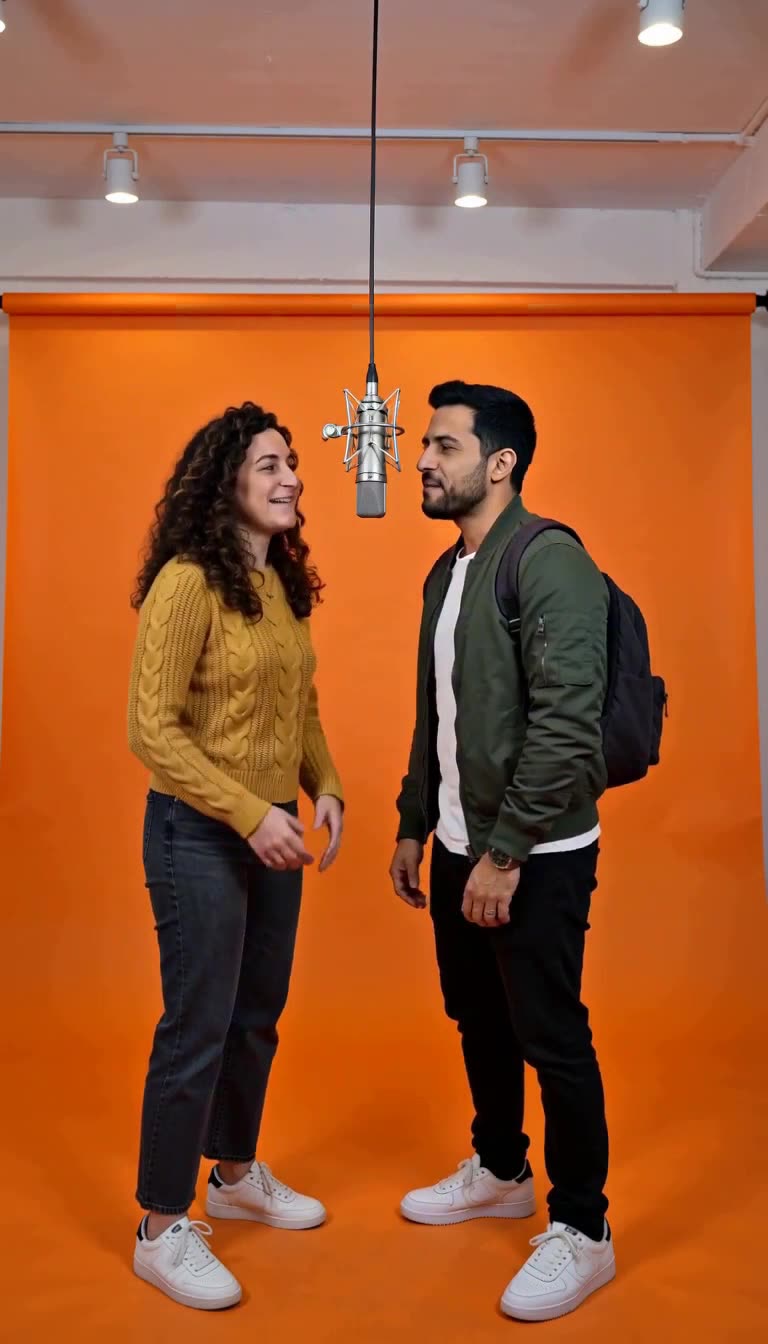
用两张照片(人或宠物)做 Hotel Lobby AI 视频:橙色影棚里隔着一支吊麦对唱,固定机位全身镜头,5–15 秒。10 秒 125 积分。
MiniMax H3 Max · 63 积分起
实测记录 2026-10-05
MiniMax H3 Max · 本站实测样片Summrs AI 替代:热门玩法视频
Summrs AI 的替代选择:Hotel Lobby、Raindance、Bulin 47 三种玩法,放 1 到 2 张照片,生成 5 到 15 秒的新视频,按条计费。不做换脸。
MiniMax H3 Max · 63 积分起
实测记录 2026-10-11
 Veo 3.1 Fast · 本站实测样片
AI 说唱视频生成器
写好歌词,就能得到带伴奏、人声和角色对口型说唱的 AI 说唱视频,由 Veo 3.1 Fast 生成。仅限原创角色,生成前先看报价。
Veo 3.1 Fast · 100 积分起
实测记录 2026-09-30
更多 AI 视频热门玩法
- 拥抱小时候的自己 AI
- 遇见年长的自己 AI
- AI 长大视频生成器
- AI 拥抱视频生成器
- AI 生日视频制作
- 让宠物说话 AI
- 宠物变人 AI
- 彩虹桥宠物纪念 AI 视频
- AI 变老视频
- AI 猫咪视频生成器
- AI 狗狗视频生成器
- AI 万圣节视频生成器
- 侏儒怪踮脚舞 AI
- AI 圣诞老人视频生成器
- AI 排灯节视频生成器
- AI 感恩节视频
- AI 圣诞视频生成器
- AI 新年视频生成器
- AI 春节视频
- 性别揭晓视频制作
- Raindance AI 视频
- Babydoll 舞 AI
- AI 舞蹈视频
- 加油站舞 AI
- Hotel Lobby AI 视频
- AI 丧尸趋势视频
- 人脸鸽子 AI
- Heads Will Roll 舞 AI
- 爆米花火山 AI 视频
- AI ASMR 视频
- AI 大脚怪视频
- AI 说唱视频
- 全部 AI 视频热门玩法