
Model updates
Gemini Omni 1.1 Flash 使用指南:设置、提示词与实测样片
规划分镜,查看一条真实的 Gemini Omni 1.1 Flash 样片,生成前核对参数与积分报价。
Gemini Omni 1.1 Flash 是谷歌的音视频模型,官方文档里带有生成之后继续调整的能力:用更低分辨率打草稿、用首尾帧引导转场、延展镜头,以及输出更高分辨率的成片。Cicadas 运行的是其中的文生视频和图生视频能力;本文后面提到的首尾帧、延展和高清放大,均为谷歌自己文档记录的能力,并不是本页当前提供的功能。
在 Cicadas 上试用: Gemini Omni 1.1 Flash 已上线 Gemini Omni Flash 页面。支持文字或一张图片生成,可选 4、6 或 8 秒,720p 或 1080p,16:9 或 9:16 画幅。每段成片都自带生成音频,本页没有静音选项。生成前会显示准确积分报价:4 秒 720p 为 100 积分,8 秒 720p 为 200 积分,8 秒 1080p 为 300 积分。生成失败会自动退回积分,每条成功的成片都是可下载、可在“我的视频”中找回的私有 MP4。
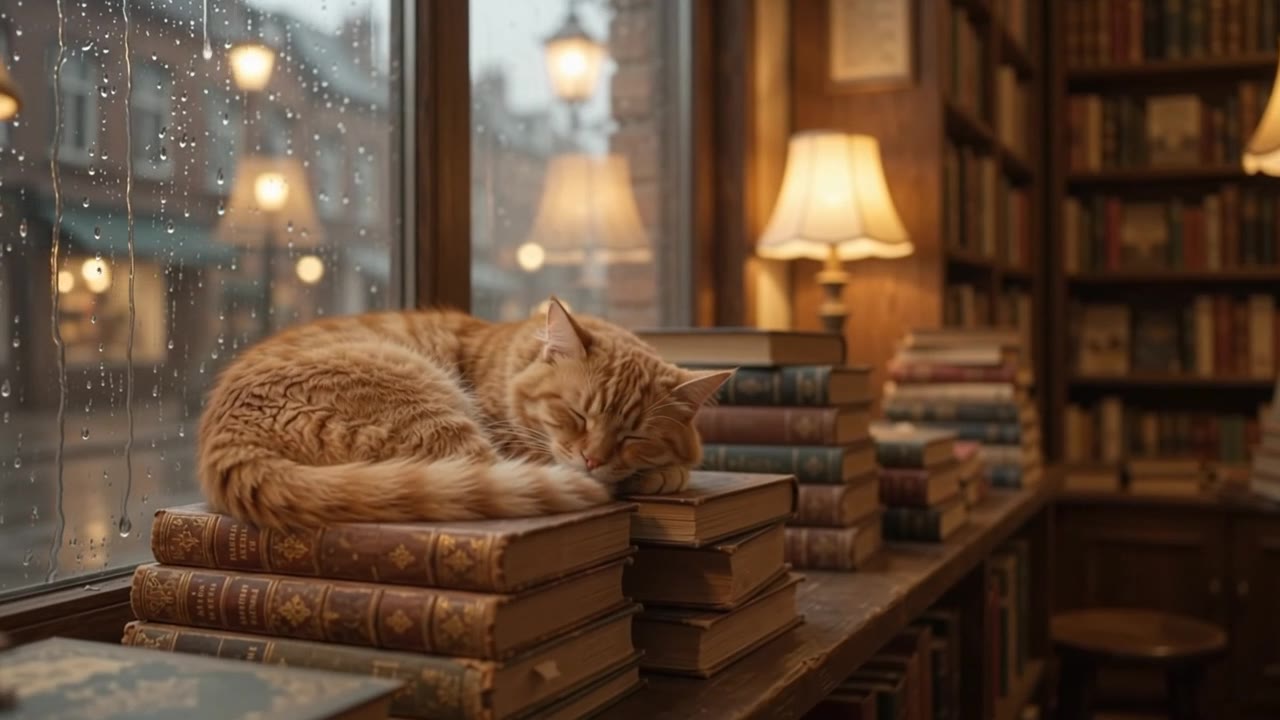
这条实测样片
生成于 2026 年 9 月 27 日:文生视频,4 秒,720p。
提示词要求一只姜黄猫在雨夜书店橱窗边的书堆上熟睡,并带有轻柔雨声和远处雷声。画面基本符合要求,但自动音频分析检测到的是柔和的环境音乐,而不是提示词要求的雨声和雷声。这提醒我们:在提示词里描述具体音效只是一个请求,不是保证——生成后一定要实际听一遍音轨,再决定是否采用。
(自动音频分析由 google/gemini-3.5-flash-lite 完成,属于机器识别,不是人工听审。)
写一版分镜提示词
选一个能用几个具体细节判断成败的镜头,同时把想要的声音和画面一起描述出来。下面是一版未经测试的额外思路,不是第二条实测样片:
一艘红色小纸船从画面左三分之一处漂向浅水洼中央。镜头保持地面视角。阴天的反光在船后轻轻荡漾。单个连续运镜,不出现新的纸船,不带文字,结束时纸船停在画面中央附近。
生成前先决定:纸船形状稳定重要,还是结束位置精确更重要,每次只改一个变量,这样才能看出到底是哪个改动起了作用。不要在第一次尝试里同时塞入新主体、复杂动作和大幅度运镜。
谷歌文档里、本页之外的能力
谷歌8 月 27 日的发布公告描述了镜头延展、首尾帧控制、360p 草稿与 4K 高清放大。这些都是谷歌官方公布的产品能力,不是 Cicadas 的 Gemini Omni Flash 页面当前能执行的步骤——本页目前只提供文生视频和图生视频。
模型参考文档确认稳定版模型名为 gemini-omni-1.1-flash,支持文字、图片与视频输入,常规输出为 3–10 秒,用于剪辑或延展的视频输入最长 10 秒——生成一段成片的时长和延展后整段序列的时长是两个不同的限制,而且延展本身在本页并不提供。如果需要首尾帧或延展,可以直接看谷歌的 Flow 创作功能更新,或者使用 Cicadas 的首尾帧视频页面——它用另一个模型实现了类似的两帧思路。
生成后再检查一遍
先按正常速度完整看一遍,再去看单帧细节,重点检查人脸、logo 和直线边缘——在我们的样片里,猫爪和书脊是个不错的检查起点。用帧提取工具做近距离检查。把源图和通过的成片按镜头分类保存;有意义的版本命名,比一堆都叫“final”的文件更好用。
如果要跨多个镜头做延续和修改,可以继续看商品视频制作器。